
Как расшифровать много файлов через API
Один файл — это клик, сто файлов — это программа. API берёт те же файлы, отдаёт ту же расшифровку с теми же сегментами и голосами и оплачивается по объёму аудио, а не подпиской.
API — это тот же движок с другой дверью. Он нужен там, где файлы идут сотнями: у поддержки лежит папка с записями, у бэк-офиса — голосовой архив, агенту надо прочитать, что было сказано. Сама расшифровка не меняется: тот же текст, те же сегменты, те же голоса.
Как расшифровать много файлов через API
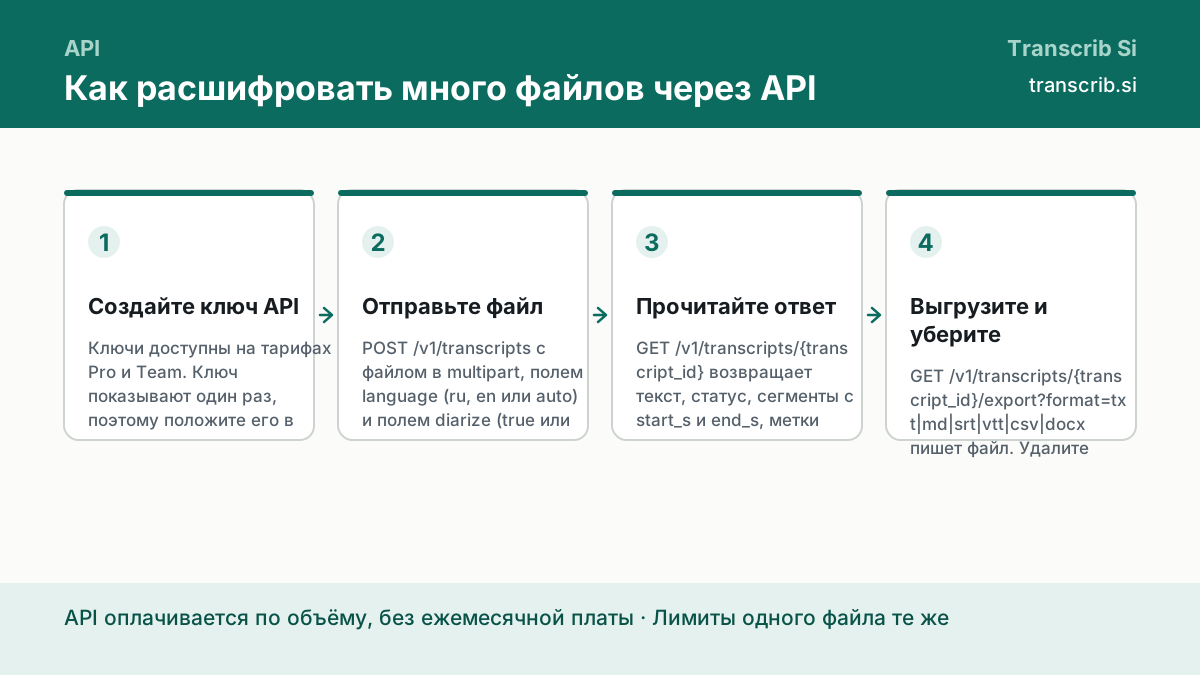
Создайте ключ API
Ключи доступны на тарифах Pro и Team. Ключ показывают один раз, поэтому положите его в переменные окружения машины, а не в код: ключ в репозитории — это ключ в руках всех, кто его читает.
Отправьте файл
POST /v1/transcripts с файлом в multipart, полем language (ru, en или auto) и полем diarize (true или false). Файл до 8 МБ уходит одним запросом, больше — через разбитую загрузку.
Прочитайте ответ
GET /v1/transcripts/{transcript_id} возвращает текст, статус, сегменты с start_s и end_s, метки голосов, язык и длительность. Тот же объект, что и в приложении, и то же, что стоит проверить, прежде чем отдавать расшифровку дальше.
Выгрузите и уберите
GET /v1/transcripts/{transcript_id}/export?format=txt|md|srt|vtt|csv|docx пишет файл. Удалите расшифровку, когда файл записан, и посмотрите /v1/usage, чтобы увидеть, сколько объёма забрал месяц.
Нужные эндпоинты
Сервис больше, чем это, но конвейеру файлов хватает четырёх эндпоинтов и одного заголовка.
| Эндпоинт | Что делает |
|---|---|
| POST /v1/api-keys | создаёт ключ; ключ показывают один раз |
| GET /v1/api-keys | список ключей без их значений |
| POST /v1/transcripts | загружает файл до 8 МБ и запускает расшифровку |
| POST /v1/uploads/init, PUT /v1/uploads/{id}/chunk?index=N, POST /v1/uploads/{id}/complete | разбитая загрузка для файла больше 8 МБ |
| GET /v1/transcripts/{id} | текст, статус, сегменты, голоса, язык |
| GET /v1/transcripts/{id}/export?format=… | файл в нужном формате |
| GET /v1/usage | объём текущего месяца |
Файлы больше 8 МБ
Файл больше 8 МБ не уходит одним запросом. Загрузка открывается, файл отправляется частями, загрузка закрывается. Размер одной части приходит в ответе на первый запрос, в поле chunk_size, — клиенту не нужно его угадывать.
- POST /v1/uploads/init с именем, размером и типом файла — в ответе upload id и chunk_size;
- PUT /v1/uploads/{id}/chunk?index=N для каждой части, сырыми байтами;
- POST /v1/uploads/{id}/complete — после этого начинается расшифровка.
Как оплачивается API
API оплачивается по объёму аудио отдельно от любой подписки, без ежемесячной платы. Лимиты одного файла такие же, как в приложении: 64 МБ и 120 минут, на любом тарифе.
Сначала расшифруйте один файл в браузере
Виджет ниже — тот же движок, что и API. Когда расшифровка одного файла верная, запрос, который делает то же самое в цикле, пишется в десять строк.
Перетащите аудио- или видеофайл
или — mp3, wav, m4a, mp4, до 64 МБ и двух часов
Расшифровка работает и без аккаунта: войдите, чтобы текст, история и выгрузка оставались у вас.
Аккаунта ещё нет? Бесплатный тариф не требует карты. Создайте аккаунт или войдите.
Вопросы о API
Нужна ли подписка, чтобы пользоваться API?
API оплачивается по объёму аудио и не имеет своей ежемесячной платы. Ключи доступны на тарифах Pro и Team.
Как безопасно хранить ключ?
Положите его в переменные окружения машины, а не в код и не в репозиторий. Ключ показывают один раз при создании, а ключ в публичном репозитории — это ключ в руках всех, кто его читает.
Что будет, если запрос не прошёл?
Каждый эндпоинт отвечает ошибкой в одном формате: {"error": {"code": "...", "message": "..."}}. Читайте код, а не сообщение: он одинаков на всех эндпоинтах, и именно по нему программа и должна ветвиться.
Лимит одного файла другой?
Нет. У API те же лимиты на файл, что и в приложении: 64 МБ и 120 минут. Более длинную запись приходится резать, и команда есть в гайде про форматы файла.
Может ли агент обойтись без программы?
Да. Сервер MCP отдаёт четыре инструмента — transcribe_audio, summarize_transcript, extract_actions и list_transcripts, — и плагины Claude и ChatGPT используют тот же сервер.
Страницы, которые идут с этим гайдом
Все эндпоинты, заголовок, ошибки и форматы.
Четыре инструмента для агента, который работает с записями.
Форматы, размер и лимиты одного файла.
Марк Бурмистров, основатель.
Эндпоинты, заголовок, форма ошибки и лимиты на этой странице взяты из контракта сервиса и его документации. Автор страницы и издатель сайта — один и тот же человек.